Lavagne e tablet
Immagini con scrittura manuale ebraica e formule matematiche, inclusi contenuti con numeri complessi.
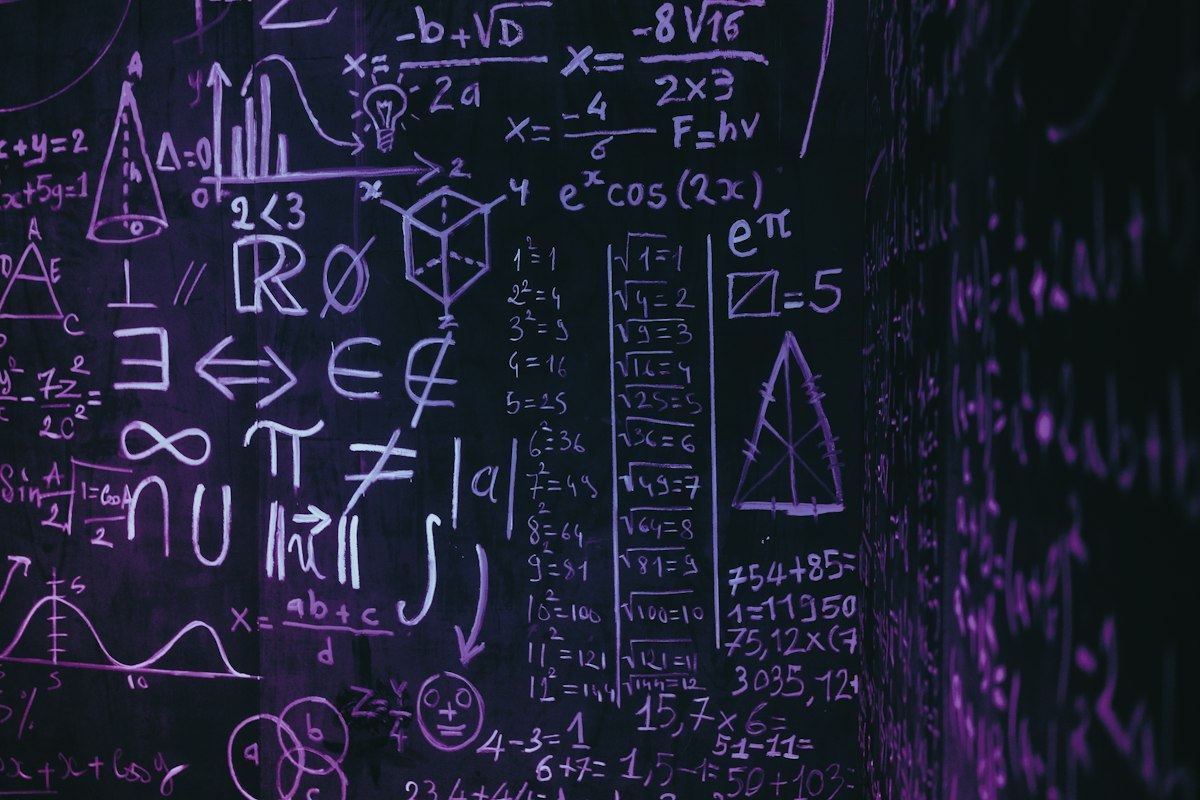
Il progetto, realizzato nel febbraio 2026, nasceva dall’esigenza di leggere contenuti scritti a mano in ebraico su lavagne e tablet. Le immagini comprendevano anche formule matematiche con numeri complessi: il riconoscimento doveva quindi affrontare una combinazione di lingua, simboli e struttura delle espressioni, all’interno dello stesso materiale visivo.
Ho seguito il lavoro dalla ricerca iniziale al modello personalizzato. La prima parte ha confrontato le soluzioni disponibili; la seconda ha costruito un percorso di annotazione e addestramento sui dati del cliente. L’accuratezza riportata è passata da risultati iniziali inferiori al 65% a un valore intorno al 96% con il modello adattato. Queste misure descrivono la valutazione svolta nel progetto e il suo specifico materiale.
Le immagini non erano scansioni di testi stampati o fotografie di appunti su carta. La scrittura proveniva da lavagne e tablet, con lettere e simboli tracciati manualmente. Il materiale da interpretare univa ebraico e matematica: una formula contiene elementi il cui significato dipende anche dalla posizione reciproca, mentre un testo richiede di conservare la relazione fra i caratteri che lo compongono.
Prima di scegliere una soluzione, era necessario verificare cosa riuscissero effettivamente a leggere i modelli esistenti su questo compito. Ho quindi confrontato approcci diversi, includendo modelli di Claude e OpenAI, Google Vision e soluzioni OCR come PaddleOCR, insieme ad altri strumenti orientati al riconoscimento delle formule. Il confronto riguardava il materiale del cliente, non una graduatoria generale dei prodotti.
Nella valutazione iniziale anche il risultato migliore rimaneva sotto il 65% di accuratezza. Questa distanza dall’obiettivo rendeva necessario lavorare sui dati e sul modello. La sfida era passare da un riconoscitore generico a un sistema adattato alle caratteristiche della scrittura e dei contenuti effettivamente presenti nel progetto.
Ho scelto di partire da un modello PaddleOCR preaddestrato e di adattarlo attraverso fine tuning. Il punto di partenza offriva un modello già formato sul riconoscimento, da specializzare usando gli esempi del cliente. Il lavoro si è quindi concentrato sulla preparazione delle annotazioni e sull’addestramento per riconoscere la combinazione di ebraico manoscritto e formule su lavagne e tablet.
L’annotazione ha collegato le immagini ai contenuti che il modello doveva imparare a leggere. Questa fase è parte sostanziale della soluzione: l’addestramento dipende dalla corrispondenza fra ciò che compare nell’immagine e il risultato atteso. Ho seguito il percorso dai dati annotati al modello adattato, fino alla valutazione delle letture ottenute sul materiale del progetto.
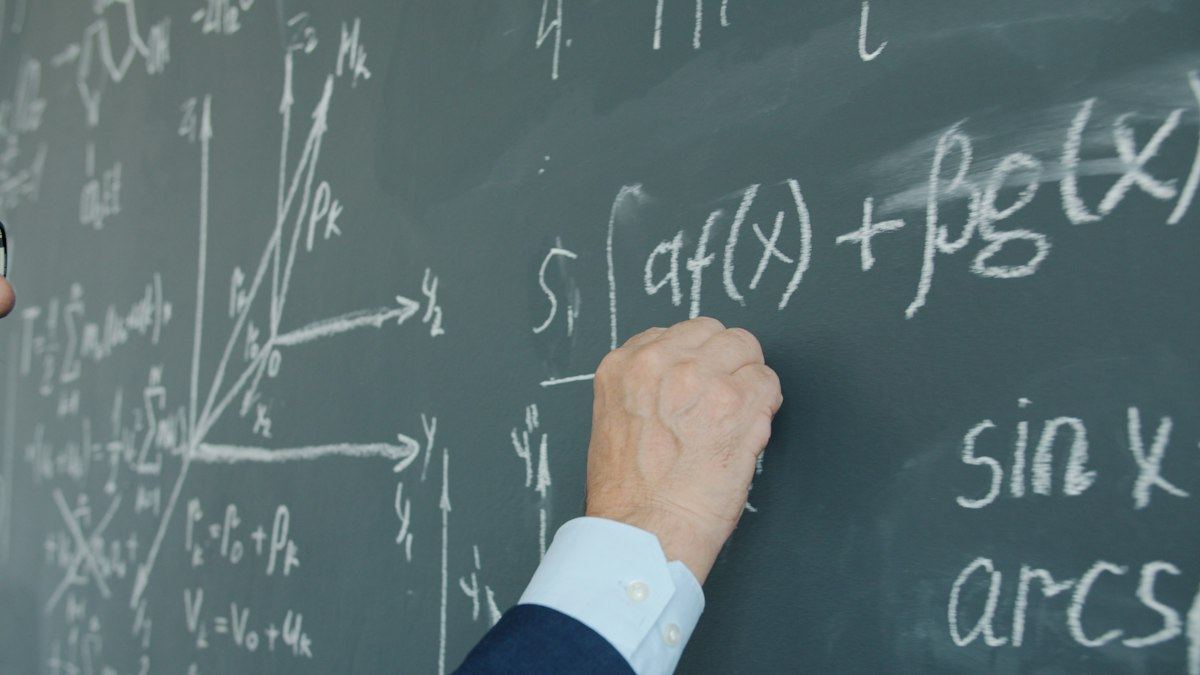
Immagini con scrittura manuale ebraica e formule matematiche, inclusi contenuti con numeri complessi.
Preparazione dei dati del cliente e addestramento di un modello PaddleOCR a partire dalla base preaddestrata.
Lettura dei contenuti e valutazione del modello personalizzato rispetto al riferimento iniziale del progetto.
Schema descrittivo del flusso di lavoro del progetto.
4 fasi, dalla preparazione iniziale agli strumenti da consegnare.
Ho iniziato verificando le capacità dei modelli disponibili per il problema specifico. La ricerca ha considerato sia modelli multimodali sia servizi di visione e strumenti OCR, includendo soluzioni dedicate alla lettura dei contenuti matematici.
Il confronto ha fornito un riferimento iniziale concreto: sul materiale analizzato il risultato migliore non raggiungeva il 65%. Questo esito ha orientato la scelta verso un modello personalizzato, invece di fermare il lavoro all’utilizzo diretto di un servizio generico.
Ho preparato le annotazioni necessarie a descrivere la scrittura presente nelle immagini del cliente. Lavagne e tablet sono rimasti il riferimento del lavoro: gli esempi dovevano rappresentare il tipo di contenuto che il modello avrebbe dovuto riconoscere.
Il compito richiedeva attenzione sia alle lettere ebraiche sia agli elementi matematici. L’annotazione ha reso esplicito il risultato atteso, creando il collegamento fra il contenuto visivo e il segnale usato durante l’addestramento.
Ho utilizzato il modello PaddleOCR preaddestrato come base per il fine tuning con i dati annotati del cliente. L’obiettivo era adattarne il comportamento alla scrittura manuale e ai contenuti del progetto, mantenendo un percorso mirato al problema da risolvere.
La personalizzazione ha portato il modello a lavorare su esempi pertinenti al suo utilizzo. Il lavoro sui dati e quello sull’addestramento sono stati quindi sviluppati insieme, come componenti dello stesso processo di miglioramento del riconoscimento.
Ho valutato il modello personalizzato sul materiale del progetto e confrontato il risultato con il riferimento iniziale. L’accuratezza raggiunta è stata intorno al 96%, rispetto al livello inferiore al 65% ottenuto dalla migliore soluzione nella prima valutazione.
Il risultato riassume il valore dell’intervento: la ricerca ha individuato il limite di partenza, mentre annotazione e fine tuning hanno adattato il riconoscimento al caso concreto. Il progetto si è concluso con il modello personalizzato e il lavoro di valutazione sui dati del cliente.
Il progetto è stato completato nel febbraio 2026 con un modello PaddleOCR personalizzato per il riconoscimento di ebraico scritto a mano e formule matematiche su lavagne e tablet. Il risultato comprende la ricerca sui modelli, le annotazioni e l’addestramento sui dati del cliente.
L’accuratezza intorno al 96% descrive il risultato riportato per questa valutazione. Il miglioramento rispetto al riferimento iniziale mostra il contributo del lavoro specifico sui dati: il modello è stato adattato alla scrittura e ai contenuti richiesti, invece di affidare l’intero compito a un riconoscitore generico.
Le accuratezze riportate si riferiscono al confronto iniziale e alla valutazione del modello personalizzato sui dati di questo progetto.
>90%errori individuati
Rilevamento e correzione dei difetti nelle tabelle PDF
>90%precisione nei test
Estrazione dati da PDF e fatture
Descrivimi cosa vuoi ottenere e quali dati hai a disposizione. La prima call di 30 minuti è gratuita.